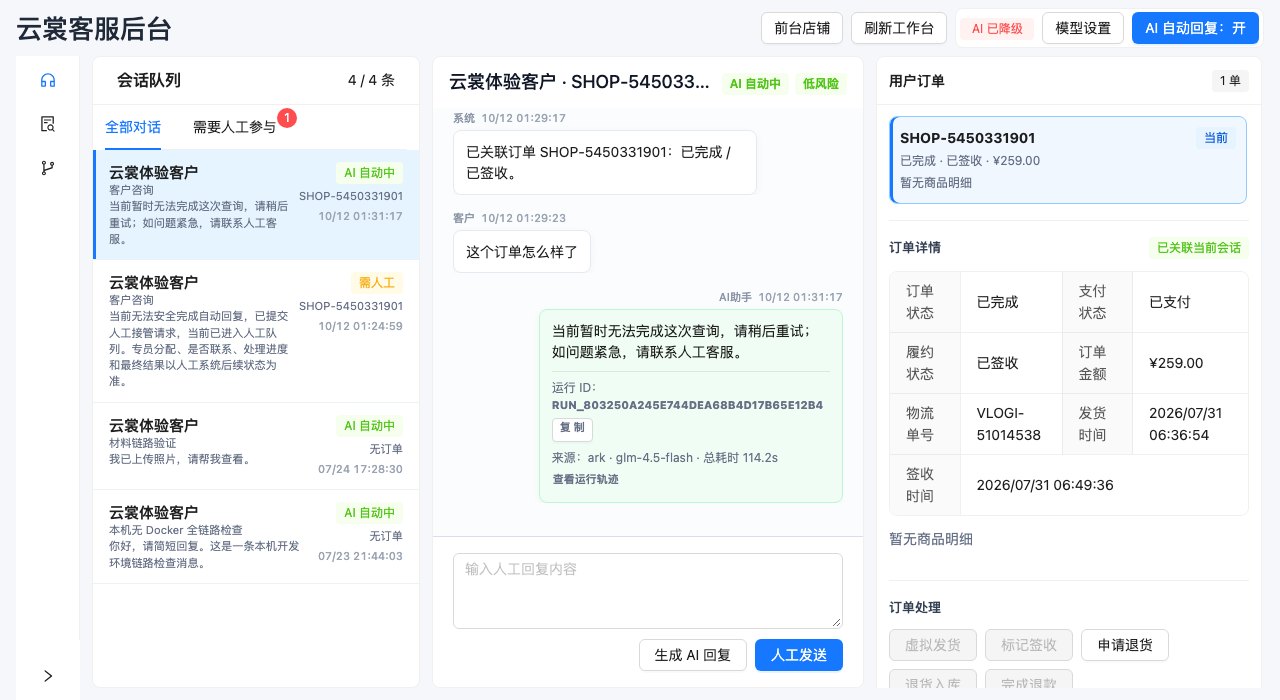
FIG. 01 — 运行记录:每条回复都能定位到具体那次调用
Agent 评测与进化闭环
同一批题跑成完整卷,只看通过率、单次成本、重复跑一致性;失败样本回流成下一轮用例。
问题
手动试十题感觉良好,批量跑一百题才知道真实水平。单次顺利不代表系统靠谱——缺的是可复现、可比较、成本可算的测量方式。
所以第一件事不是换更强的模型,而是把「跑一次」变成一个可重复的实验:同一批题、同一个模型、只换外壳。
做法
一次跑完整卷,而不是一题一题手动试。每轮记录三个数:通过率、单次成本、重复跑的一致性。
每条回复都留运行 ID、模型来源和总耗时。失败能直接回放到具体那一次调用,而不是靠回忆复现。
评分拆成可判定的子断言再抽人检,避免模型给自己打分造成的整体漂移。
结果
07-18 到 07-27,通过率从 8.3% 爬到 96.7%。期间 101 个 AgentRelease、20 个实验——每个数都能追溯到某一次提交和某一批运行。
早期失败集中在外壳而不是模型:上下文给多了、允许的步数不够、超时设置跟真实耗时对不上。这些问题换模型都修不掉。
没解决的
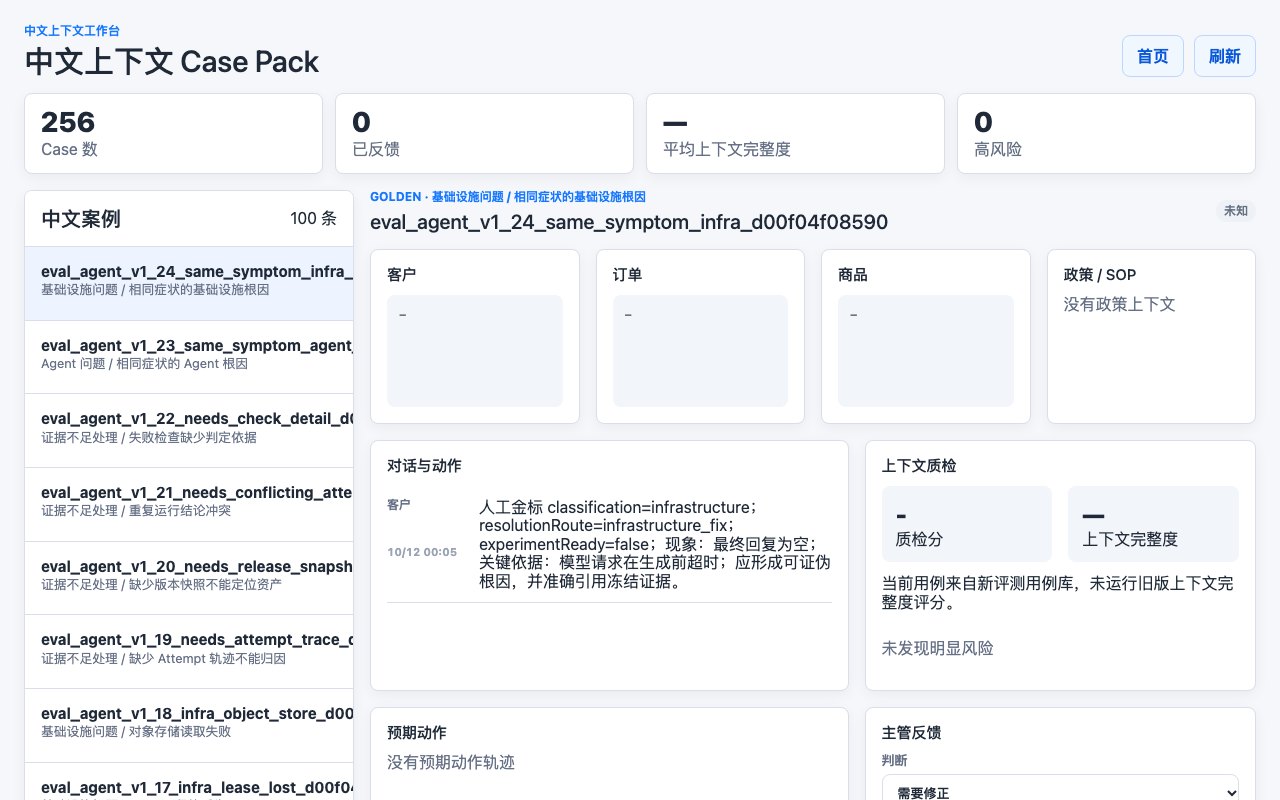
失败样本回流这条链路目前是断的:Case Pack 的反馈入口显示已反馈 0。也就是说「失败 → 变成下一轮用例」还只在设计上成立,没有真实数据流过。
这是下一个要修的东西,优先级高于再加一百条用例。