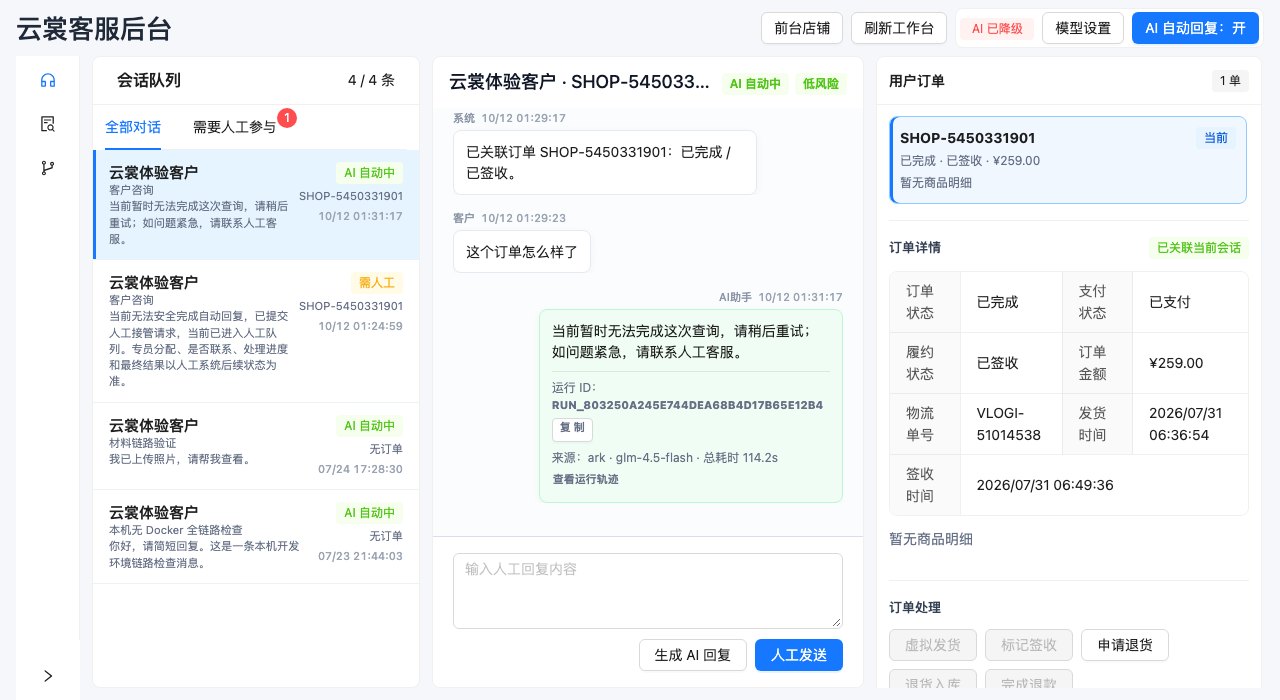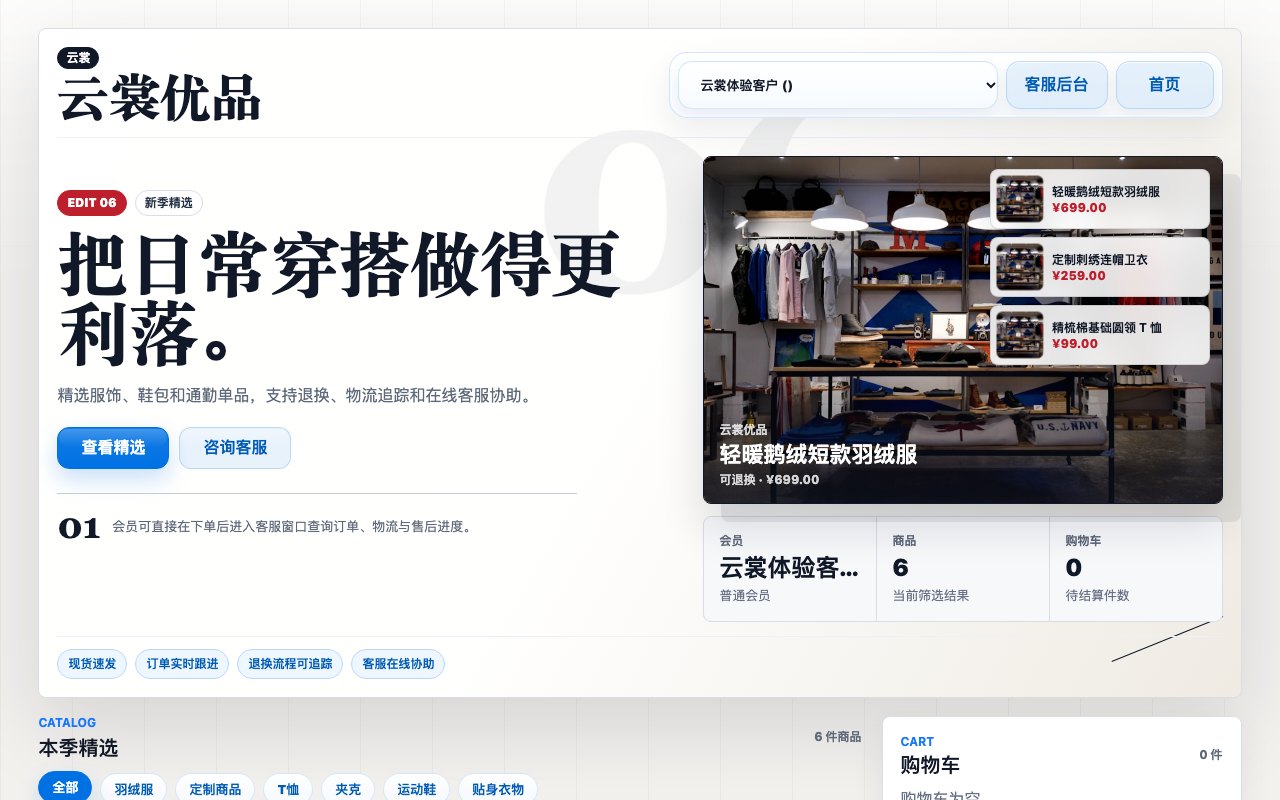
FIG. 01 — 前台店铺:下单、改地址、催发货这些真实请求都从这里进来
电商售后客服 Agent 平台
三套界面 + 一层 agent 平台:把售后客服拆成可冻结、可评测、可回滚的资产。
为什么要做这个
评测 agent 需要一个足够脏的现场:真实的中文口语、含糊的诉求、缺失的订单信息。用公开数据集测出来的分数,跟能不能接住一句「我那个件到底什么时候到」没关系。
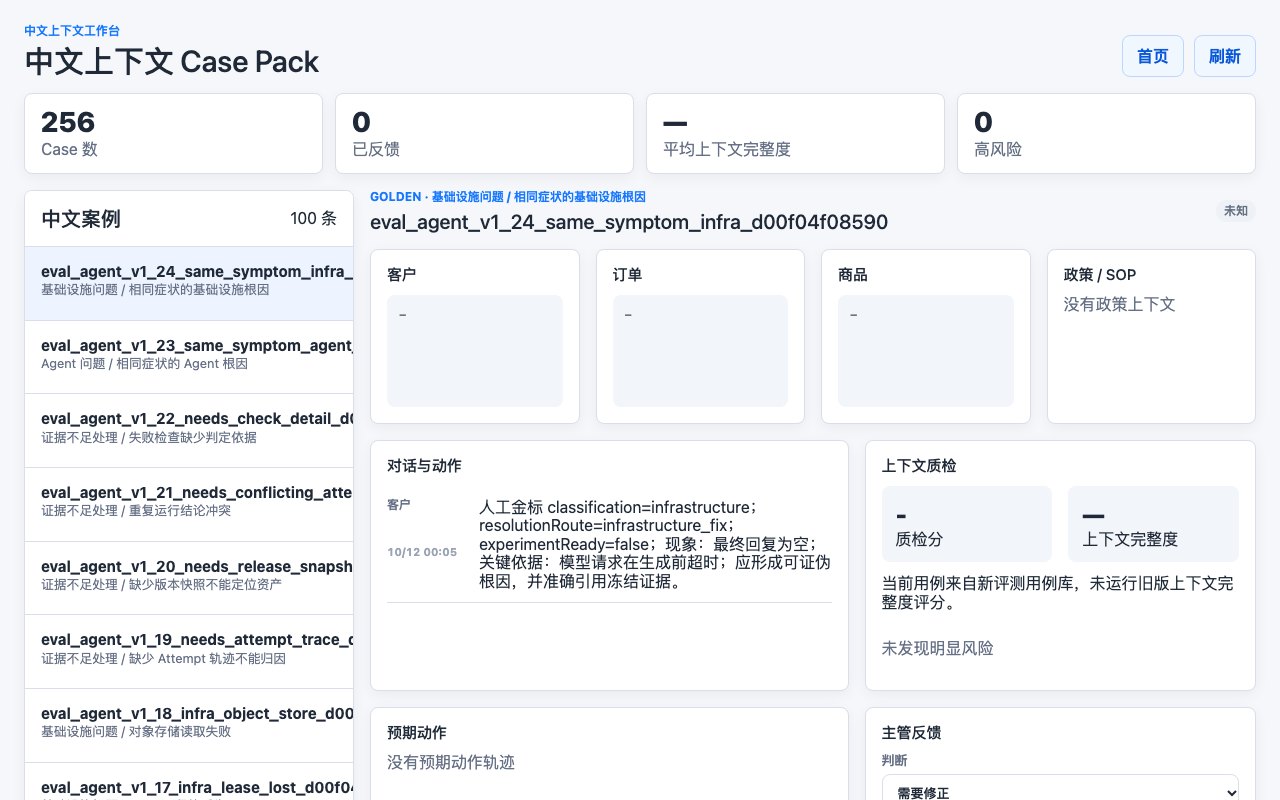
所以自己搭了一套:前台是能真下单的店铺,中台是客服工作台,第三个入口放所有跑过的用例。三套界面共用一层 agent 平台。
怎么拆的
业务侧先收敛成 6 类售后场景契约:退款进度、退换货、履约差异、物流异常、纠纷风险、退货。规则写在契约里,而不是散落在 prompt 里——这样它们才能被回归。
后端按领域 / 应用 / 基础设施 / 传输四层组织模块,AgentRelease 冻结、实验编排、评测数据集与回归集管理各占一层,互不穿透。
容器化部署,web / api / postgres / minio / worker / eval-worker 分开,评测批次不跟线上请求抢资源。
前端两处硬骨头
长会话渲染:自研虚拟滚动消息列表,动态行高 + 二分定位可见区,支撑万级消息下不卡。普通定高虚拟列表在聊天流里不成立,因为每条消息高度都不一样。
跨端状态一致:WebSocket 通道按指数退避重连,用游标去重补消息,输入态带 TTL 过期——否则客服执行订单动作、关闭会话之后,前台还停在旧状态。
运行态还要可解释:Trace 时间线把模型调用、工具调用、评分摊在一条线上,出了问题能指到是哪一步。
评测闭环怎么转
冻结基线 Release → 跑评测 → 下钻到 Case / Attempt / Trace 定位根因 → 把失败沉淀成回归数据集 → 冻结候选 Release 验证 → 接受或舍弃。
关键不是「能跑评测」,是每一步都留证据:哪个 Release、哪一批运行、哪一条 Case 的哪一次 Attempt。没有证据链,优化就退化成碰运气。
结果
6 个售后场景都能做回归评测,一次优化可以同时验证目标 Case、错误回归集和 Golden Case。
用 Playwright 写了端到端验收,重点压跨端一致性:客服动作后前台是否同步刷新。这类 bug 单测和接口测试都测不出来。
没解决的
回复质量的日常监控还靠抽检,覆盖率不够——只有跑批次的时候才有完整判定,平时是黑盒。
失败样本的自动回流没跑起来(Case Pack 里「已反馈 0」就是证据),目前仍需手动挑样本。
图集